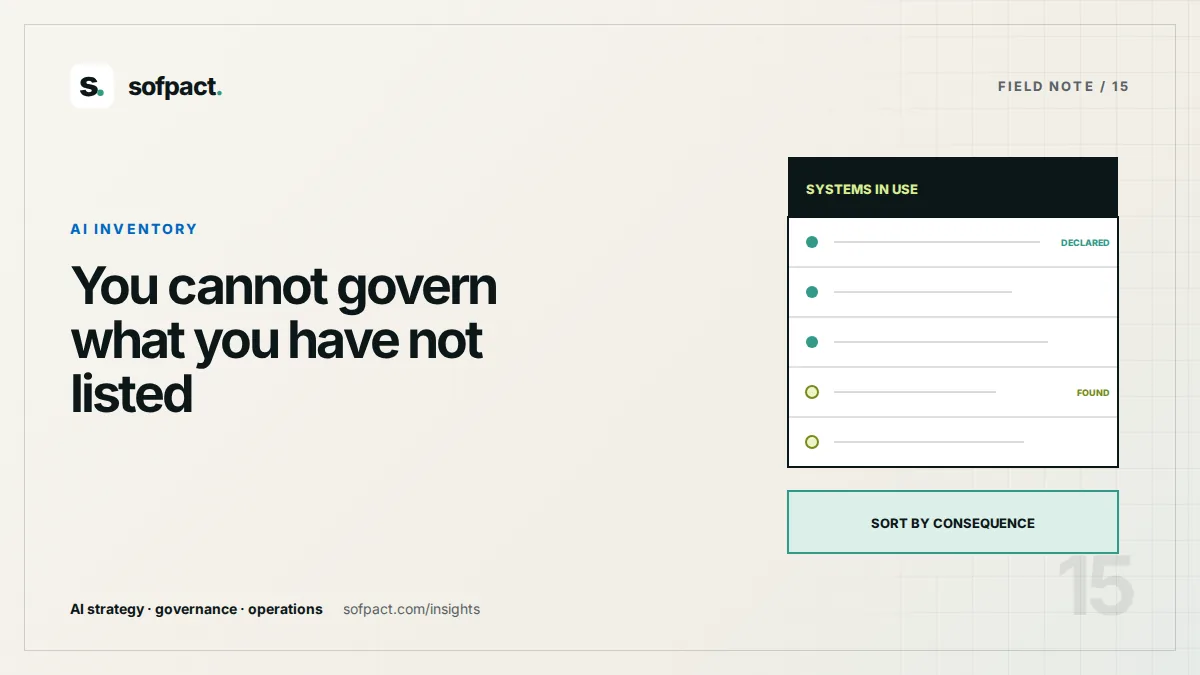
Demandez à une organisation combien de systèmes d’IA elle exploite : la réponse est le plus souvent une liste de projets. Le nombre réel est plus élevé, et l’écart n’est presque jamais la faute de quelqu’un. C’est un effet de la manière dont l’IA arrive aujourd’hui : non comme une décision d’achat, mais comme une fonctionnalité ajoutée à un logiciel déjà en service.
La plateforme client a gagné le résumé automatique au dernier trimestre. L’outil de recrutement classe les candidatures. Le centre de services suggère des résolutions. Le complément tableur rédige des formules. Rien de tout cela n’est passé par un processus de validation IA, parce que rien de tout cela n’a été acheté comme de l’IA.
Pourquoi le compte est toujours trop bas
L’adoption progresse vite : selon Eurostat : utilisation de l’intelligence artificielle dans les entreprises, environ 20 % des entreprises de l’UE d’au moins dix salariés utilisaient des technologies d’IA en 2025, contre 13,5 % l’année précédente, et 55 % parmi les grandes entreprises. Cette enquête interroge les entreprises sur ce qu’elles utilisent sciemment. Les fonctions intégrées à des logiciels achetés sont systématiquement sous-comptées — par la statistique comme par le registre interne.
Ce n’est que rarement un problème de connaissance. C’est un problème d’inventaire. Il est difficile de comprendre une population qu’on n’a pas dénombrée, et la plupart des organisations pilotent à partir d’une liste constituée en demandant autour de soi.
Un exemple qui fonctionne à grande échelle
L’idée qu’on puisse simplement publier la liste a été éprouvée en public. Amsterdam et Helsinki ont lancé en 2020 des registres municipaux d’algorithmes, consignant à quoi sert chaque système, quelles données il utilise, comment une personne intervient et comment il a été évalué au regard des risques. Le registre d’Amsterdam a depuis été absorbé par un registre national.
Le registre des algorithmes du gouvernement néerlandais a été lancé en décembre 2022 et recense aujourd’hui plus de 1 500 algorithmes, centrés sur les systèmes à fort impact, y compris l’IA à haut risque, publiés par des ministères, des agences et des communes. Quoi qu’on pense de la publication, l’exercice démontre un point plus étroit et plus utile : dénombrer les systèmes algorithmiques d’une organisation vaste et décentralisée est faisable. Cela a été fait, à l’échelle nationale, en public, par des entités disposant de bien moins de liberté commerciale qu’une entreprise privée.
Une organisation privée ne publiera presque jamais. La version interne du même document reste pourtant le document de gouvernance le plus utile dont la plupart des maisons ne disposent pas.
Ce que doit contenir une entrée
Un inventaire ne sert que si chaque ligne répond aux questions posées sous pression. Neuf champs couvrent la quasi-totalité des cas.
- Ce qu’il fait, en langage d’exploitation. Non pas « plateforme d’apprentissage automatique » mais « classe les sinistres entrants pour l’affectation aux gestionnaires ».
- Qui en répond. Une personne nommée, ayant autorité pour le modifier ou l’arrêter — ni une équipe, ni un comité.
- Quelle décision il influence, et si une personne examine avant que le résultat ne produise ses effets.
- Quelles données entrent, y compris s’il s’agit de données personnelles et sur quelle base légale.
- Où tourne le modèle, et qui est le fournisseur.
- Quelle version est en service, et par quel canal un changement vous parviendrait.
- Quelles preuves existent qu’il fonctionne — une évaluation, un échantillonnage, une affirmation du fournisseur, ou rien, ce qui est une réponse acceptable tant qu’elle est consignée.
- Ce qui se passe s’il se trompe, décrit comme une conséquence pour une personne ou pour l’activité, et non comme un niveau de gravité.
- La date du dernier réexamen.
Résistez à la tentation d’ajouter d’emblée une cotation du risque. Les cotations déclenchent des débats de calibrage avant même que la liste soit complète — et c’est la liste qui a de la valeur.
Comment trouver ce que vous exploitez déjà
Demander aux équipes de se déclarer produit la liste que vous aviez déjà. Cinq sources fournissent le reste.
- Les pièces d’achat et de comptabilité. Passez au crible vingt-quatre mois de dépenses fournisseurs à la recherche d’outils d’IA, et des renouvellements où un produit existant a ajouté des fonctions d’IA.
- Les notes de version des fournisseurs. Pour les vingt systèmes les plus centraux, lisez ce qui a été livré sur l’année écoulée. C’est là que se trouve l’essentiel de l’IA non recensée.
- Les journaux d’identité et d’accès. L’authentification unique et les données de frais montrent à quels services les personnes se connectent réellement, y compris ceux que personne n’a déclarés.
- Les enregistrements de changement. Les intégrations ajoutées aux systèmes centraux sont en général documentées, même quand la capacité sous-jacente ne l’est pas.
- Un entretien avec chaque responsable opérationnel. Pas un formulaire. Demandez ce qui, dans leur processus, produit désormais une suggestion, un classement, un score ou un brouillon — et qui agit en conséquence.
Attendez-vous à ce que le premier passage honnête fasse apparaître deux à cinq fois plus de systèmes que prévu. C’est le résultat normal, et c’est l’intérêt de l’exercice.
Que faire de la liste
Ne gouvernez pas tout de la même façon. Triez par conséquence : qu’arrive-t-il à un client, à un salarié ou à une obligation lorsque ce système se trompe ? La plupart des entrées se révèlent être des commodités à faible conséquence, qui ont besoin d’un responsable et d’une date de réexamen, et de rien d’autre. Un petit nombre pèse sur des décisions concernant des personnes — crédit, emploi, éligibilité, tarification, accès à un service — et mérite un vrai travail.
Ce tri est aussi l’entrée de presque tout le reste. Il détermine ce qui relève du cadre réglementaire européen sur l’IA, qui rattache les obligations à l’usage et non à la technologie. Il détermine ce que couvrirait un système de management selon ISO/IEC 42001. Et c’est la fonction Map du NIST AI Risk Management Framework, qui place délibérément le recensement et le contexte avant la mesure et la gestion, pour la raison simple que les deux autres sont indéterminées sans lui.
C’est enfin le document qui répond à un questionnaire de due diligence, au formulaire de proposition d’un assureur, à une revue de sécurité menée par un client ou à la première question d’une autorité. Ces demandes arrivent de plus en plus souvent, et celles qui y répondent vite sont les maisons qui ont fait ce travail avant qu’on le leur demande.
Quinze jours, pas un programme
Cela ne demande pas de comité de pilotage. Une personne ayant accès aux pièces d’achat et l’autorisation de poser des questions directes produit un premier inventaire défendable en une quinzaine de jours. La version un sera incomplète ; publiez-la tout de même en interne, car une liste incomplète attire les corrections qu’une page blanche n’obtient jamais.
Fixez ensuite une date de réexamen et tenez-la. Un inventaire exact une fois est un document. Un inventaire exact chaque trimestre est un contrôle.
Si vous souhaitez faire réaliser ce travail de façon indépendante et rapide : c’est la première étape habituelle du travail sur le parc d’IA, cadré comme un diagnostic.
Cet article est une adaptation de l’original anglais. En cas de divergence, la version anglaise fait foi.